目次9
LLMO対策とは、ChatGPTやGeminiなどの中で文章をつくっているAIのモデル(大規模言語モデル)に、自社のことを正しく覚えてもらうための対策です。LLMOは、Large Language Model Optimization(大規模言語モデル最適化)の略です。
日本では、AIが検索して答える場合も含めた、AI検索の対策全体をLLMO対策と呼ぶこともあります。検索まで含めた全体のやり方は、AIO対策にまとめています。この記事では、LLMOの名前のとおり、AIのモデルそのものが、学習で何を覚えているかに絞って説明します。
呼び名の違いと、何から始めるかはAI検索対策(AIO・GEO・LLMO)完全ガイドにまとめています。
この記事は、AIの答えを測る診断サービスを提供している AI検索ドック(ステラジェント株式会社)が書いています。
この記事のポイント
- LLMO対策は、AIが検索せずに、学習で覚えている知識だけで答える場合に向けた対策
- 主なモデルの知識は2026年3〜6月ごろまで。今日出した情報が入るのは次のモデルから
- 学習用のボットを止めず、外のサイトでくり返し語られること。llms.txt で学習される根拠はない
LLMO対策とは? 学習の知識と、検索の違い
呼び名と、やることの全体
| 呼び名 | 使われる場面 | くわしい記事 |
|---|---|---|
| LLMO | 日本で最初に広まった呼び名。名前のとおりAIのモデルそのものへの最適化 | この記事(学習の知識) |
| AIO | 日本で、AI検索の対策の総称として広がっている | 検索まで含めたやり方の全体はAIO対策へ |
| GEO | 海外での標準の呼び名 | 海外の実例はGEO対策へ |
| AEO | 日本でも使われ始めた呼び名。AIの「答え」に選ばれることに注目する | SEOとの違いとやり方はAEO対策へ |
検索まで含めたAI検索の対策の全体は、次の6つの手順です。具体例はAIO対策にまとめています。
- お客様がしそうな相談で、いまの状態を測る
- AIが裏で使う検索の言葉と、引用しているページを見る
- 自社サイトの土台を整える(AIのボットが入れて、検索の索引に載る)
- 自社サイトの中身を、相談に答える形にする
- 外のサイトで、紹介される場所を増やす
- 同じ条件で、1か月ごとに測り直す
この記事が扱う「学習の知識」は、このうち5の外のサイトでの紹介と、3のボットの設定に深く関わります。
検索しないときと、検索するときで、答えはこう変わる
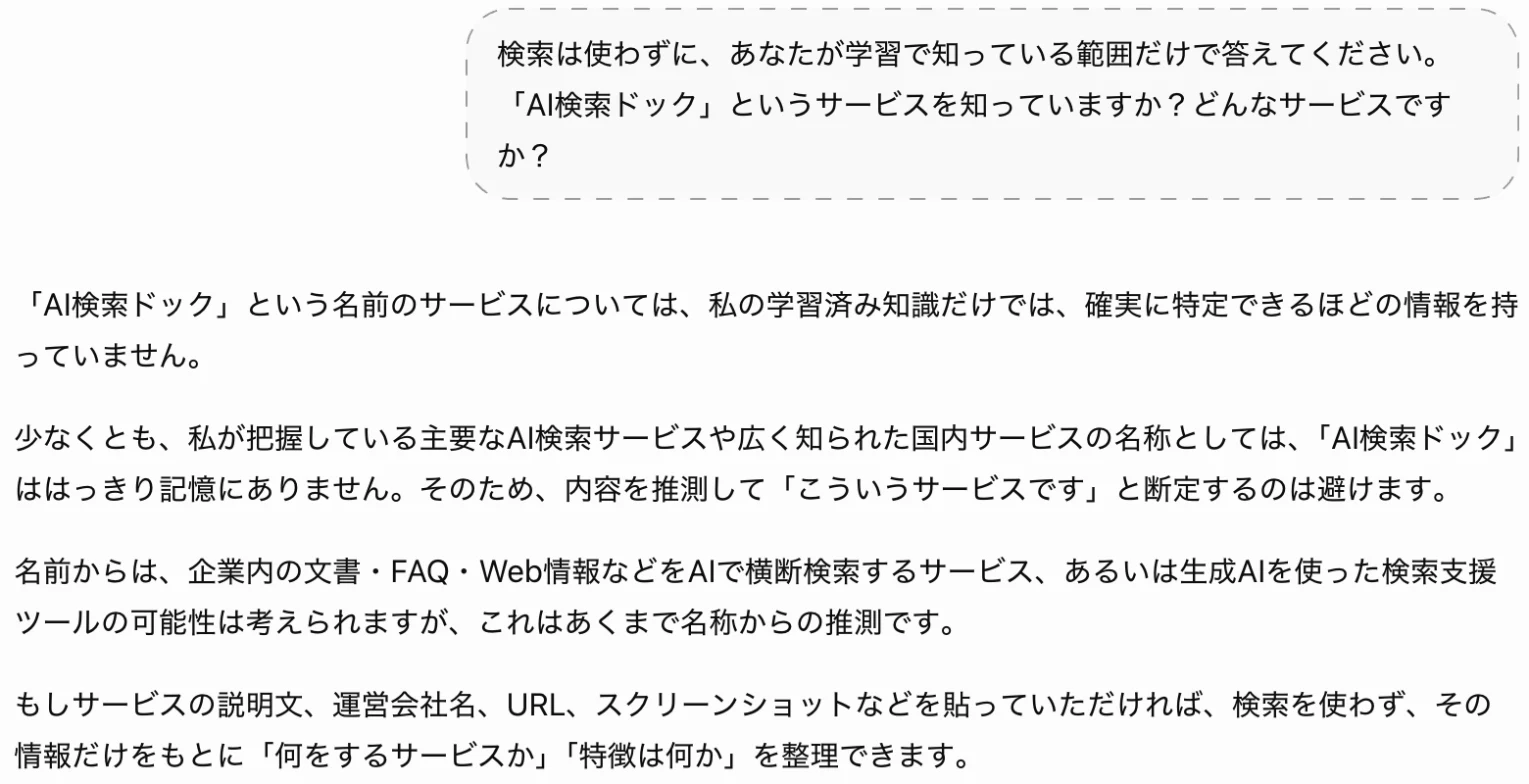
AIの答え方には2つあります。学習で覚えている知識だけで答える場合と、検索して見つけたページをもとに答える場合です。違いを、私たちのサービスで試しました(2026年10月7日、ChatGPTの一時チャット)。
まず、検索を使わず、学習で知っている範囲だけで答えるように頼みました。
次に、同じ会話で、検索して答えるように頼みました。
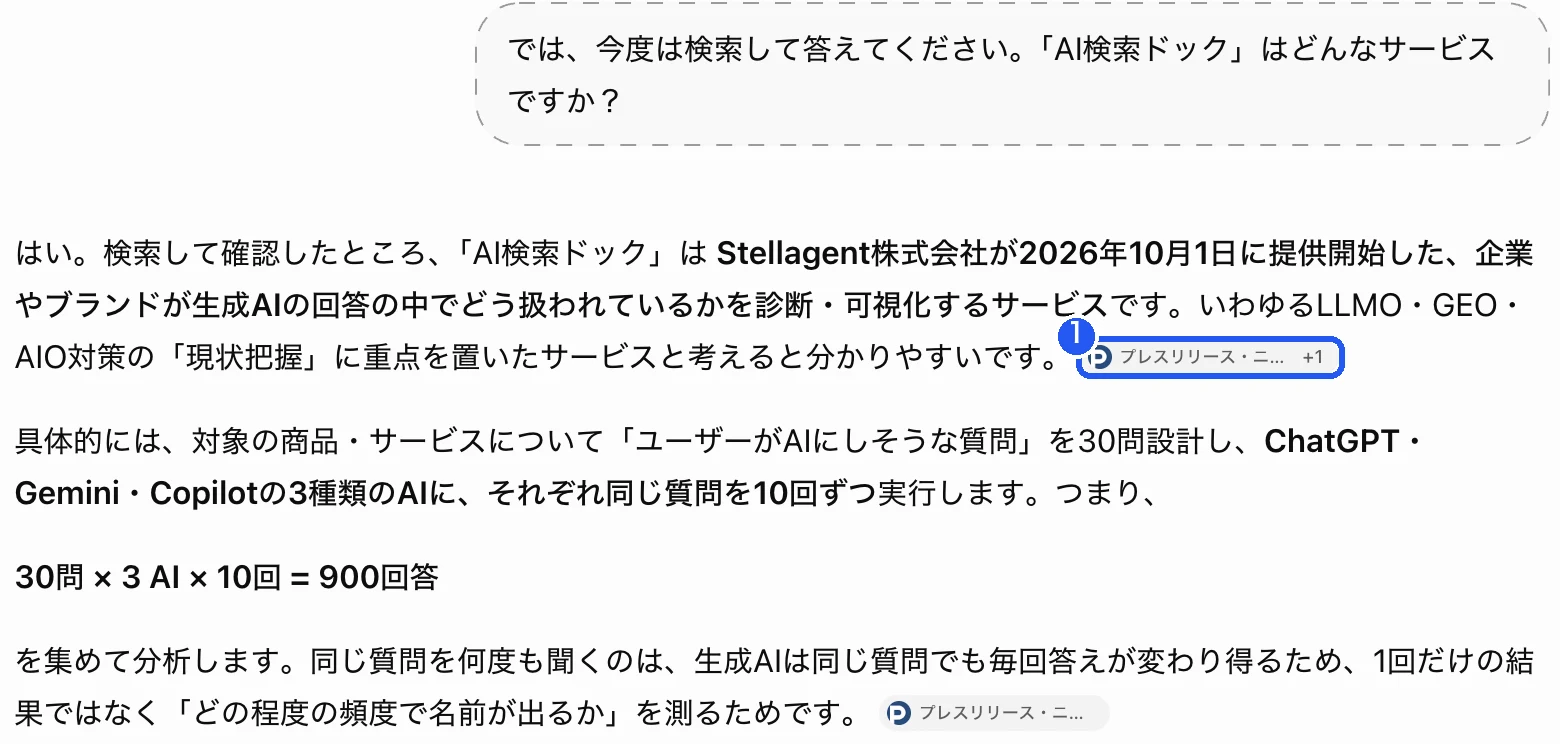
AI検索ドックは2026年10月1日に始めたサービスで、いまの主なモデルが学習したデータより後にできました。だから、検索しなければ知らず、検索すれば正しく答えられます。 LLMO対策は、この「検索しないときの知識」に、自社が正しく入るようにすることです。
学習の知識と検索、どちらが大事か
いまの主なAIは、「おすすめの〇〇は?」のような相談では、ほとんどの場合検索してから答えます。私たちが計測や診断を探す相談を900回聞いたときも、889回(98.8%)の答えに検索して参照したページが付いていました(2026年10月1日、ChatGPT・Gemini・Copilot)。
| 学習の知識(LLMO) | 検索(AIO) | |
|---|---|---|
| 使われる場面 | 検索しない答え。会話の前提や、AIの「印象」 | 「おすすめは?」のような相談のほとんど |
| 何でできているか | モデルを作るときに集めたデータ | 答えるその場で検索して読んだページ |
| 変えてから効くまで | 次のモデルが出るまで。数か月から1年ほど | 検索の索引に載れば、数日から数週間 |
| 確かめ方 | 検索を使わずにAIに聞く | 検索ありでAIに聞き、引用元を見る |
すぐに効くのは検索のほうなので、対策の中心はAIO対策です。一方で、学習の知識は、検索して答えるときにも「どの会社を思い浮かべて調べるか」に影響すると考えられます。学習の知識は、時間をかけて積み上げる土台です。
AIの学習のデータと、知識の期限
学習のデータは何でできているか
各社は、学習に使うデータを公式に次のように説明しています(2026年10月7日に確認)。
| 会社 | 公式に書いていること |
|---|---|
| OpenAI | インターネットで自由に見られる公開の情報、第三者と組んで使う情報、利用者やトレーナーが出す情報。有料の壁の向こうからは意図して集めない。AIで作ったデータも増えている |
| Google(Gemini) | 公開のウェブ文書、公開のデータセット、クローラーで集めたデータ、商用のライセンス契約のデータ、利用者のデータ、AIで作ったデータ。robots.txt を尊重する |
| Anthropic(Claude) | 公開の情報、公開・非公開のデータセット、利用者のデータ、AIで作ったデータの組み合わせ |
どのページが、どれだけ使われたかは、どの会社も公開していません。
知識には期限がある
モデルが覚えているのは、学習に使ったデータの時点までです。この時点を「知識のカットオフ」と呼びます。
| モデル | 知識のカットオフ | 公開 |
|---|---|---|
| GPT-6 Astra | 2026年4月30日 | 2026年9月3日 |
| GPT-6 Luna | 2026年5月18日 | 2026年9月22日 |
| Claude Opus 5.5 | 2026年6月 | 2026年9月22日 |
| Gemini 3.8 Flash | 2026年3月(分野によっては2025年1月まで) | 2026年9月2日 |
カットオフから公開まで、2〜10か月ほどかかっています。今日出した情報がAIの知識に入るのは、早くても次のカットオフを持つモデルで、その公開はさらに数か月後です。 また、カットオフまでに公開したページが、すべて入っているわけではありません。2025年11月の研究では、公表のカットオフが2025年1月のモデル(Claude Sonnet 4)でも、2023年2月ごろから知識が薄くなり始めていました。公表の時期と、実際に知識が入っている時期は、ずれます。
学習用のボットと、検索用のボットは別
AIの会社は、ウェブのページを集めるボットを、目的ごとに分けています。学習用のボットを止めても検索での表示は止まらず、検索用のボットを止めても学習は止まりません。
| 会社 | 学習用 | 検索・回答用 | 利用者の指示で読みに来る |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Google-Extended(集めたものを学習に使ってよいかの指定) | Googlebot | — | |
| Apple | Applebot-Extended(同じく指定) | Applebot | — |
| Common Crawl | CCBot(集めたデータが公開され、多くのモデルの学習に使われる) | — | — |
| Meta | Meta-ExternalAgent | Meta-WebIndexer | Meta-ExternalFetcher |
| Amazon | Amazonbot | Amzn-SearchBot | Amzn-User |
私たちのサイト(stellagent.ai)に来たボットを数えると、28日間(2026年9月8日〜10月5日)で、学習用のボットは25,768回来ていました。AIのボット全体の34.6%です。
25,768回
学習用のボットが来た回数
34.6%
AIのボット全体に占める割合
215回
Common Crawl(CCBot)が来た回数
いちばん多かったのは ByteDance の Bytespider(15,505回)で、Amazonbot(3,965回)、Meta の学習用(2,907回)、ClaudeBot(2,346回)、GPTBot(830回)と続きました。Google-Extended と Applebot-Extended は、ボットとしては来ません。Google や Apple の通常のボットが集めたものを、学習に使ってよいかを決める指定なので、記録には出ません。
AIに覚えてもらうためにできること
研究では、AIが検索なしでどれだけ正しく答えられるかは、その名前が学習のデータにどれだけ多く出てくるかに強く左右されることが分かっています。201のモデルを測った2026年の研究では、GPT-5.5 でも、よく閲覧・引用される事実は99%答えた一方、あまり知られていない事実では67%、さらに知られていない事実では20%まで下がりました。学習のデータに1回しか出てこない事実は、まちがいの元になる、という研究もあります。
会社やブランドでも同じです。検索を切った6つのモデル(GPT-5.5・Claude Opus 4.7・Gemini 3.1 Pro など)に、商品のおすすめのブランドを聞いた2026年9月の研究では、L.L.Bean や Philips のような大手でも、一度も挙がらないブランドがありました。挙がりやすさと最も結びついていたのは、広告費や Wikipedia の閲覧数ではなく、Googleで検索されている量でした(米国のブランドでの結果です)。
そこから、根拠のあるやり方は次のとおりです。
- 学習用のボットを止めていないか確かめる。 robots.txt と、配信サービス(CDN)やWAFのボット対策で、GPTBot・ClaudeBot・CCBot などを止めていないかを見ます。止めると学習に使われないと、各社が明記しています
- Common Crawl に自社のページが入っているか確かめる。 Common Crawl の索引(CDX API)で、自社のドメインを検索できます。2019年から2023年10月に出た47のモデルのうち、少なくとも64%が Common Crawl を学習に使っていました。Common Crawl は、ほかのサイトからリンクされているページほど多く集めます
- ほかのサイトで、くり返し同じ内容で語られる。 比較記事、業界のメディア、ニュースで、会社名と「何の会社か」がそろって何度も出ているほど、覚えられやすくなります。2025〜2026年の研究では、名前と答えが同じ段落に、言い換えでなく名前ではっきり書かれている回数が、正しく答えられるかと最も強く結びついていました(10億パラメータまでのモデルでの実験です)
- 名前はそろえ、説明は形を変えて出す。 会社名の表記がばらばらだと、同じ会社だと分かりにくくなります。正式名はどこでも同じにします。一方で、2026年の研究では、同じ文の言い換えを並べるより、ブログ・解説・Q&Aのように違う形で同じ事実を説明した文があるほど、モデルが覚えやすく、その差は大きいモデルほど開きました。同じ文面の使い回しは、学習のデータを作るときに重複として除かれることもあります。説明は、場所ごと・形ごとに書き分けて出します
- 大事な情報を、誰でも読めるページに置く。 OpenAI は、有料の壁の向こうからは意図して集めない、と書いています。料金や事例を、資料のダウンロードやログインの奥にだけ置くと、学習にも検索にも使われません
- AIの会社と契約しているメディアに取り上げられる。 OpenAI や Google は、ニュースの会社や掲示板の運営会社と、データを学習に使う契約を結んでいます。取り上げられた記事が学習に入る道の一つです。ただし、個別の記事が使われたかは、外からは分かりません
なお、学習のデータは英語に偏っています。Common Crawl も英語のページが多く、日本語だけで情報を出している会社は、もともと覚えられにくい立場です。2025年の研究では、英語以外で答えられた事実の一部は、英語のデータに多く出る同じ事実から移ったものでした(移る量は小さく、主な道はその言語で多く出ることです)。英語の会社概要を1ページ用意しておくことも、検討する価値があります。
Wikipedia も多くのモデルの学習に使われていますが、自社の記事を自分で書いたり直したりすることは、利益相反として強く止められています。 書かれるに値する実績を、ほかの信頼できる場所で積み上げることが先です。
出典
- 知られていない事実ほど答えられない(Incompressible Knowledge Probes、arXiv、2026年。査読前)
- 検索なしのAIが推薦するブランド(Malthouse ほか、arXiv、2026年9月。査読前)
- 1回しか出ない事実と、まちがいの関係(Kalai ほか、Nature、2026年)
- 学習のデータと知識の結びつき(LMEnt、TACL 2026)
- 違う形の説明で覚えやすくなる(Auxiliary Views、EMNLP 2026 Findings)
- Common Crawl の学習への使われ方(Mozilla Foundation、2024年2月)
- 多言語の知識の身につき方(EMNLP 2025 Findings)
- Common Crawl の索引(Common Crawl)
- Axel Springer との提携(OpenAI)
- Wikipedia:Conflict of interest(Wikipedia)
効くと言われるが、根拠がないこと
- 根拠なし
llms.txt を置けば、学習される
llms.txt を提案した人たち自身が、主に答えるときに使うためのもので、学習のためではないと書いています。学習に使うと公式に書いたAIの会社もありません。llms.txt がAI検索で効くかは、llms.txtとはにまとめています。
- 間違い
llms.txt は、robots.txt のAI版
llms.txt は、サイトの案内を書いたファイルで、読みに来てよいかを決める仕組みではありません。学習を止めたり許したりするのは、robots.txt のボットの指定です。
- 根拠なし
構造化データを入れると、学習されやすくなる
学習に効くという公式の説明はありません。Googleは、AIの機能のために特別な構造化データやファイルは要らない、と書いています。
- 間違い
サイトを直せば、すぐAIの知識に反映される
学習の知識はカットオフで止まり、次のモデルが出るまで変わりません。すぐ変わるのは、検索して答えるほうです。検索したときにAIが何を参照し、新しい情報がどれくらいで届くかは、ChatGPT・Geminiは最新の情報をどこから取っている?にまとめています。
- 間違い
一度学習されれば、ずっと覚えている
研究では、モデルは学習の途中で事実を覚えたり忘れたりをくり返し、学習のデータに1,000回以上出る事実でも、5%ほどは忘れていました。1回載っただけで定着するとは限りません。
学習の知識を確かめる方法
学習の知識だけを確かめるには、検索を使わずにAIに聞きます。 画面の ChatGPT や Gemini は、必要と判断すると自動で検索します。自動の検索を確実に切る設定は、公式のヘルプでは確かめられませんでした。上の画面のように「検索を使わずに」と頼む方法もありますが、確実なのは、開発者向けの窓口(API)で、検索の機能を付けずに聞くことです。
| AI | 検索を使わずに聞くには |
|---|---|
| OpenAI(Responses API) | ウェブ検索のツールを付けずに送る |
| Anthropic(Messages API) | ウェブ検索のツールを付けずに送る |
| Google(Gemini API) | Google検索のツール(google_search)を付けずに送る |
聞くときは、次のことを見ます。
学習の知識で見ること
- 自社の名前を出して聞いたとき、何の会社か、正しく答えるか
- 「知らない」と答えるか、それとも作り話をするか
- 似た名前の有名な会社と取り違えていないか
- 同じ質問を何回か聞いて、毎回同じように答えるか
3つ目は特に大事です。研究では、AIのまちがった答えはでたらめではなく、より有名な答えに寄ることが分かっています(GPT-3.5 と、70億〜320億パラメータの公開モデルでの結果です。最新のモデルで確かめた研究は、まだ見つかりませんでした)。名前の似た有名な会社がある場合、その会社の情報で答えてしまうことがあります。混同の切り分けと直し方はAIが自社を別の会社と混同するときに、AIがどれくらい間違えるかはAIはどれくらい間違える?にまとめています。
AI検索ドックでできること
私たちの AI検索ドック は、お客様がしそうな相談を30問つくり、ChatGPT・Gemini・GoogleのAIモードに各10回、合わせて900回聞いて、AIの答えの中で自社がどう紹介されているかを調べる診断です。検索して答える場合を中心に、名前が出た割合、引用元、内容の正しさをまとめます。学習の知識と検索のどちらに手を打つべきかも、答えの中身から判断できます。
よくある質問
LLMO対策とは何ですか?
AIのモデル(大規模言語モデル)に、自社のことを正しく覚えてもらうための対策です。日本では、AIが検索して答える場合も含めたAI検索の対策全体をLLMO対策と呼ぶこともあります。
LLMOとAIO、GEOの違いは何ですか?
目指すことは同じで、呼び名と使われる場面が違います。AIOは日本で総称として広がっている呼び名、GEOは海外での標準の呼び名です。LLMOは名前のとおり、AIのモデルそのもの、つまり学習で覚えている知識に向けた対策を指すときに使います。
AIは、学習の知識だけで答えることが多いですか?
「おすすめの〇〇は?」のような相談では、ほとんどの場合検索してから答えます。私たちが900回聞いたとき(2026年10月1日、ChatGPT・Gemini・Copilot)は、98.8%の答えに検索して参照したページが付いていました。すぐに効くのは検索の対策で、学習の知識は時間をかけて積み上げる土台です。
自社の情報がAIの学習に入るまで、どのくらいかかりますか?
どの会社も公式には書いていません。いまの主なモデルは、知識のカットオフから公開まで2〜10か月ほどかかっています。今日出した情報が入るのは、早くても次のモデルからです。
学習用のボットは止めたほうがいいですか?
止めると、そのAIの会社の次のモデルの学習に使われなくなります。自社のことをAIに覚えてもらいたいなら、止めないほうがよいです。止める場合も、検索用のボット(OAI-SearchBot など)とは別に指定します。
llms.txt を置けば、AIに学習されますか?
根拠はありません。llms.txt を提案した人たち自身が、主に答えるときに使うためのもので、学習のためではないと書いています。
Wikipedia に自社の記事を書けば、AIに覚えてもらえますか?
Wikipedia は多くのモデルの学習に使われていますが、自社の記事を自分で書いたり直したりすることは、利益相反として強く止められています。ほかの信頼できる場所で実績が語られることが先です。
AIが自社について間違ったことを覚えていたら、どうすればいいですか?
検索して答える場合は、自社サイトと外のサイトに正しい情報を書けば、比較的早く変わります。学習の知識は次のモデルまで変わらないので、正しい情報が、ほかのサイトでもくり返し同じように出ている状態をつくります。古い料金やサービス名が、ほかのサイトに残っていないかも確かめます。新しく集められるデータにも、古いページが多く混ざるからです。
まとめ
LLMO対策は、AIのモデルそのものに、自社のことを正しく覚えてもらうための対策です。
- AIの答えには、学習の知識で答える場合と、検索して答える場合がある。相談のほとんどは検索して答える
- 学習の知識には期限があり、今日出した情報が入るのは早くても次のモデルから
- 学習用のボットを止めず、ほかのサイトでくり返し同じ内容で語られることが、覚えてもらう近道
- llms.txt や構造化データで学習される、という説明に根拠はない
- 確かめるなら、検索を使わずにAIに聞き、取り違えがないかを見る